近日,教育部、国家语言文字工作委员会正式发布《机器合成普通话水平测评等级标准及测评大纲》和《人工智能 语料库基础术语》两项语言文字规范,标志着我国语言文字标准体系建设向数字化、智能化方向迈出坚实步伐。
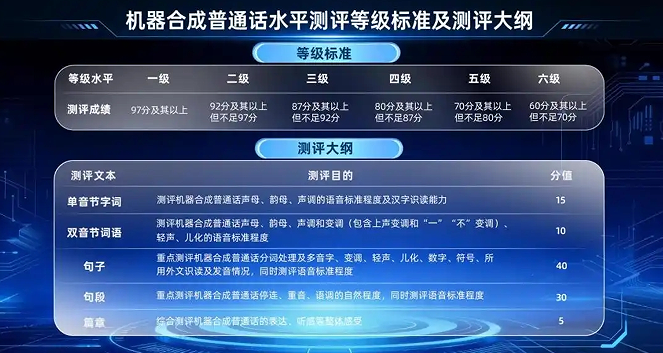
《机器合成普通话水平测评等级标准及测评大纲》首次为机器合成语音的普通话水平设立了科学、系统的等级标准和测评方法。该标准涵盖发音准确度、语调自然度、语流连贯性等核心指标,并明确了从初级到高级的分级测试方案。它不仅为智能语音技术的研发与优化提供了量化依据,也为智能客服、语音导航、有声读物等应用场景的质量评估提供了权威参考,让机器“说好普通话”有了统一的“标尺”。
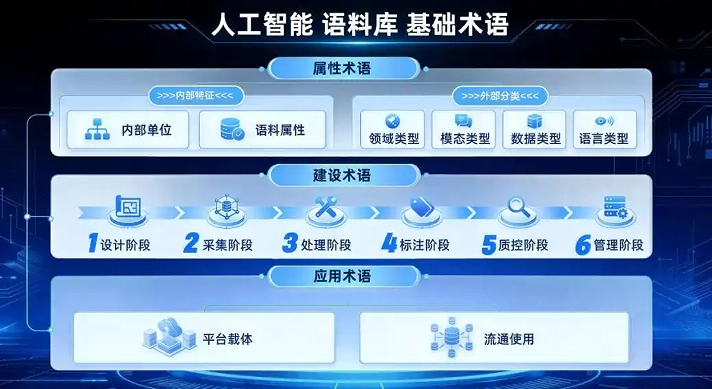
《人工智能 语料库基础术语》则聚焦人工智能发展的基础数据——语料库,系统界定了语料采集、标注、质量评估等环节。这份术语集统一了“语料清洗”“多模态标注”等新兴技术概念,规范了“语料平衡性”“标注一致性”等核心评价指标,为人工智能训练数据的标准化处理奠定了坚实基础,有效解决了行业术语混乱、标准不一的问题。
两项规范的研制历时三年,汇聚了高校、科研机构、企业的百余位专家智慧,充分吸纳了语音识别、自然语言处理等领域的最新技术成果。它们的发布,是落实《中华人民共和国国家通用语言文字法》关于“推进国家通用语言文字信息化、数字化、智能化建设”要求的重要举措,也是推动中文数字化和数据中文化的关键一步。
在人工智能深刻重塑社会的今天,语言文字标准的制定既是技术命题,更是文化战略。这两项规范的出台,不仅为人工智能领域的语言文字应用提供了统一规范,也为我国语言文字事业的高质量发展注入了新动能。